vLLM e SGLang vs DeepInfer: vale a pena hospedar DeepSeek V4.1 Flash?
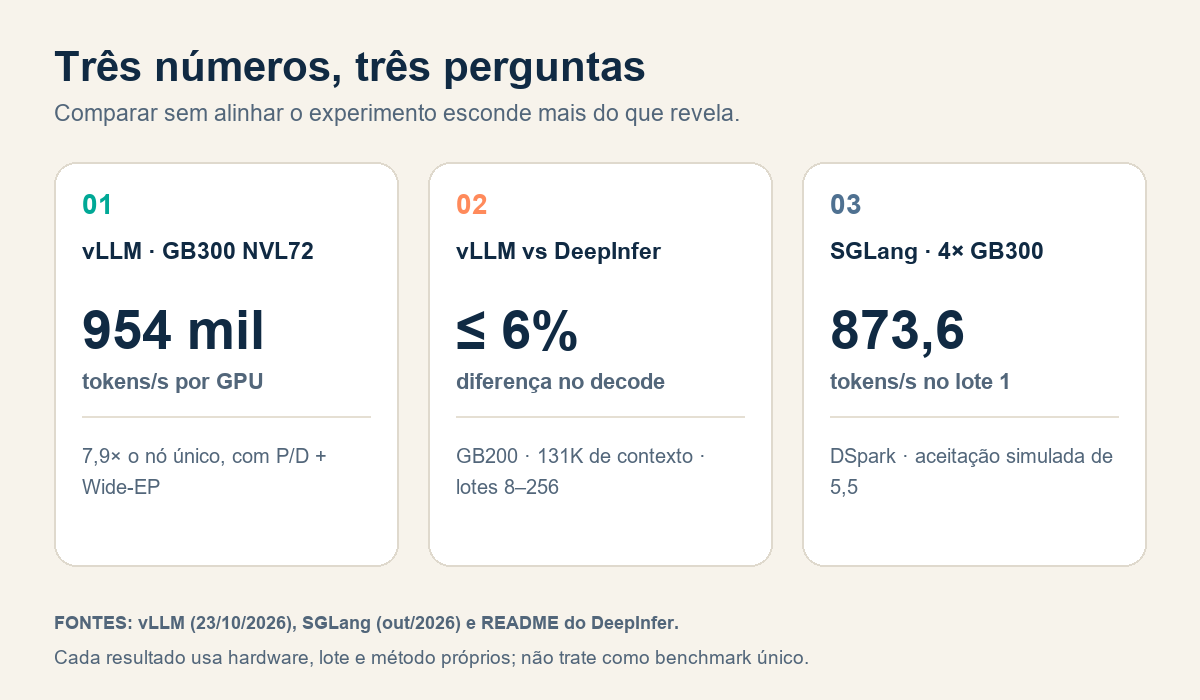
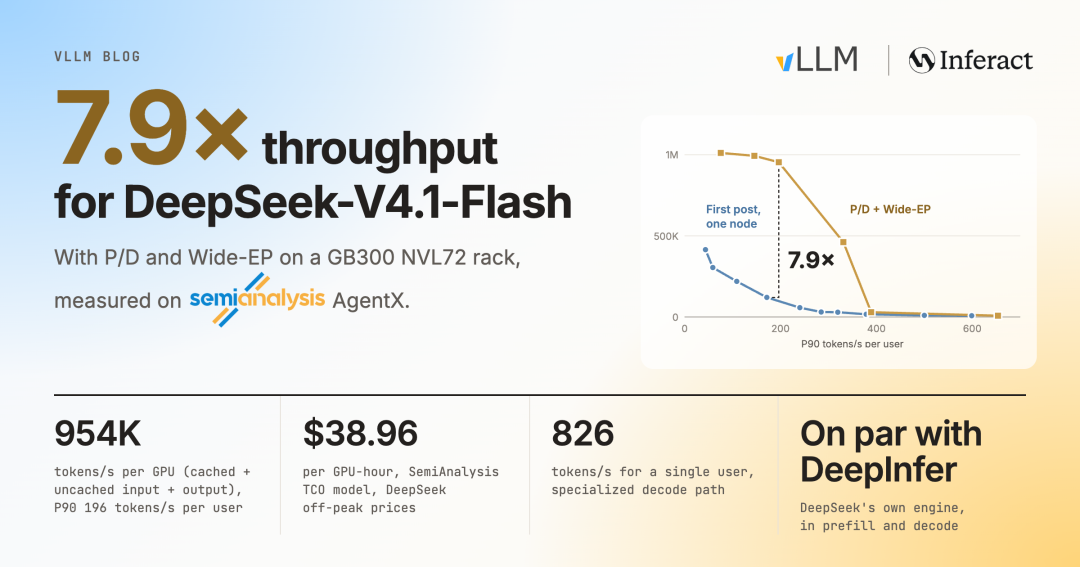
Resposta rápida: em 23 de outubro de 2026, a equipe do vLLM publicou um estudo em que o decode do DeepSeek V4.1 Flash no GB200 ficou dentro de 6% do DeepInfer entre lotes de 8 e 256, enquanto o prefill acompanhou a curva publicada pela DeepSeek. Em um rack GB300 NVL72, com separação de prefill/decode e Wide-EP, o vLLM chegou a 954 mil tokens por segundo por GPU no AgentX, 7,9 vezes o resultado de um único nó. A SGLang também mostrou uma otimização de kernel que levou o decode com lote 1 de 35,2 para 873,6 tokens/s em quatro GB300.
Esses resultados mudam a conversa sobre auto-hospedagem: um motor genérico já consegue se aproximar de um motor feito sob medida para um único modelo. Mas eles não significam que qualquer empresa deva comprar GPUs. Os testes usam hardware de data center, configurações diferentes e cargas específicas. Para a maioria dos times brasileiros, a decisão continua sendo entre montar e operar um cluster ou consumir o modelo por API.
Atualizado em 25 de outubro de 2026. Benchmarks são medições dos respectivos fabricantes ou equipes dos projetos; preços e disponibilidade devem ser confirmados antes de uma carga de produção.
O que aconteceu?
O DeepInfer é o motor de inferência que a DeepSeek usa em sua operação de grande escala. A versão aberta em outubro é uma versão offline, com kernels otimizados e foco no DeepSeek V4.1 Flash. No mesmo período, a DeepSeek publicou a curva de desempenho do motor e abriu as bibliotecas de kernel que serviram de base para ele.
O vLLM respondeu com um estudo de serving em escala. A mensagem central não é “o vLLM venceu em todos os cenários”. É mais específica: em uma comparação de decode no GB200, com contexto de 131 mil tokens e nextn=3, a vazão do vLLM ficou a menos de 6% da publicada pelo DeepInfer para lotes de 8 a 256. Já o prefill do vLLM em DEP2 no GB300 acompanhou a curva do DeepInfer, mas os conjuntos não eram idênticos: o DeepInfer usou EP4DP4, 32 especialistas redundantes e replay de 140 tokens; o vLLM usou DEP2, nenhum especialista redundante e replay de 128 tokens. Por isso, a própria equipe do vLLM diz que a diferença entre as curvas não deve ser lida como ganho de um motor sobre o outro.
Em paralelo, a SGLang publicou um estudo de otimização de kernels para o mesmo modelo. Em quatro GB300, com entrada aleatória de 4 mil tokens, saída de 1.024 tokens, DSpark ligado e comprimento de aceitação simulado em 5,5, a vazão de decode com lote 1 subiu de 35,2 para 873,6 tokens/s ao longo de 16 rodadas de otimização. É um resultado relevante para latência de um único usuário, mas não é uma comparação direta com o número de 954 mil tokens/s por GPU do vLLM, que usa outro lote, outro benchmark e outra topologia.
Três números, três recortes diferentes
| Experimento | Hardware e configuração | Resultado publicado | O que ele realmente mostra |
|---|---|---|---|
| vLLM no AgentX | GB300 NVL72, separação P/D e Wide-EP | 954 mil tokens/s por GPU; 7,9× o resultado de um nó; US$ 38,96 por GPU-hora a preços fora de pico da DeepSeek | Capacidade agregada de um rack em uma carga de agentes, contando entrada em cache, entrada sem cache e saída |
| vLLM contra DeepInfer | GB200, decode com contexto de 131K e nextn=3; lotes de 8 a 256 |
Diferença dentro de 6% na vazão de saída | Proximidade em uma configuração de decode específica, não uma classificação geral |
| SGLang | 4× GB300, lote 1, 4K de entrada e 1K de saída, DSpark e aceitação simulada de 5,5 | 873,6 tokens/s após subir de 35,2 | Efeito das otimizações de kernel em baixa concorrência |
O número de US$ 38,96 por GPU-hora também exige contexto. Ele é uma conversão da vazão medida para a receita teórica por GPU-hora usando os preços fora de pico da DeepSeek. Não é o preço que você pagará por uma GPU, nem inclui necessariamente energia, rede, armazenamento, ociosidade ou operação. Para uma empresa que compra capacidade, o custo relevante é o custo por tarefa concluída, não apenas a vazão máxima em um benchmark.
O que mudou no DeepSeek V4.1 Flash
O V4.1 Flash é um modelo de mistura de especialistas (MoE) com 552 bilhões de parâmetros totais, mas ativa cerca de 8 bilhões na entrada e 16 bilhões na saída. A arquitetura combina 20 camadas de encoder causal com 20 camadas de decoder. O cache KV global fica em aproximadamente 890 bytes por token, cerca de um quarto do V4 Flash, graças ao compartilhamento entre camadas, ao agrupamento de entradas e ao armazenamento em FP4.
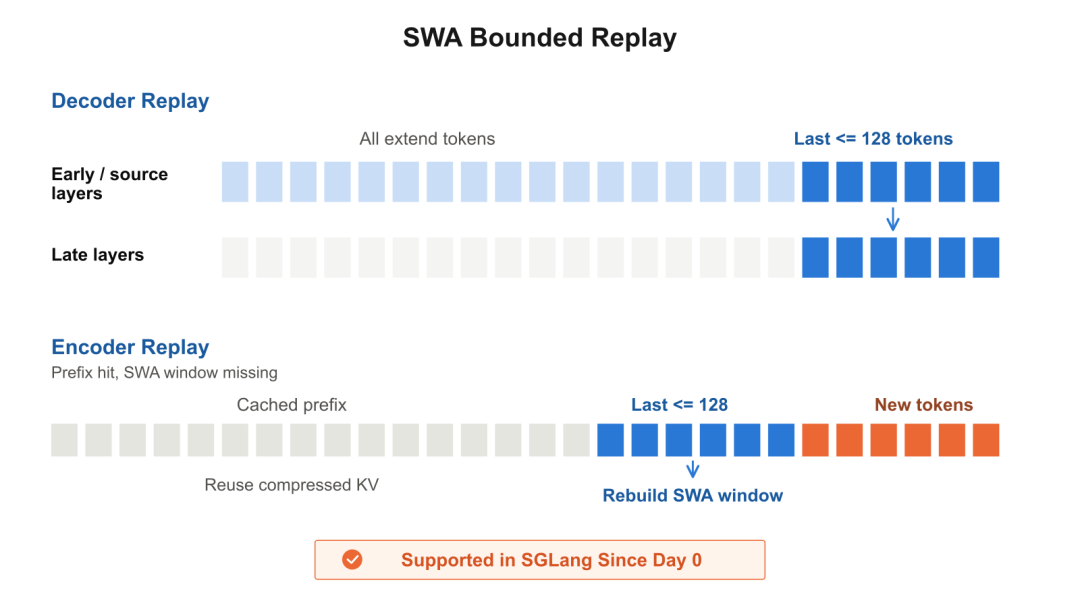
Essa estrutura explica por que o modelo é atraente para serving. Em vez de processar todo o prompt em todas as camadas, boa parte do trabalho de entrada passa pelas primeiras 20 camadas. O decoder reutiliza o KV global produzido pelo encoder e reconstrói uma janela local curta, com bounded replay dos últimos 128 tokens. O resultado é menos compute no prefill e uma pegada de memória menor, embora cada token gerado ainda atravesse todas as 40 camadas.
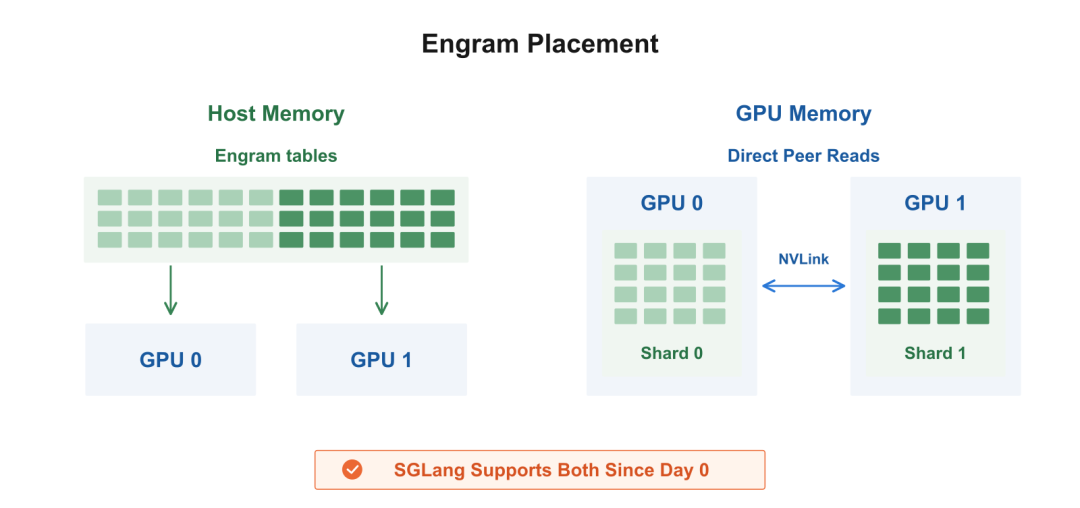
O modelo também usa Engram, uma memória de parâmetros externa ao bloco principal. A SGLang mostra que é possível colocar essas tabelas na memória do host e acessá-las por NVLink, liberando HBM para o cache KV. São detalhes de arquitetura que importam para quem vai escolher o motor: um framework genérico só extrai esse ganho se implementar corretamente o layout de memória, o replay e a comunicação entre GPUs.
Por que os motores genéricos conseguiram se aproximar?
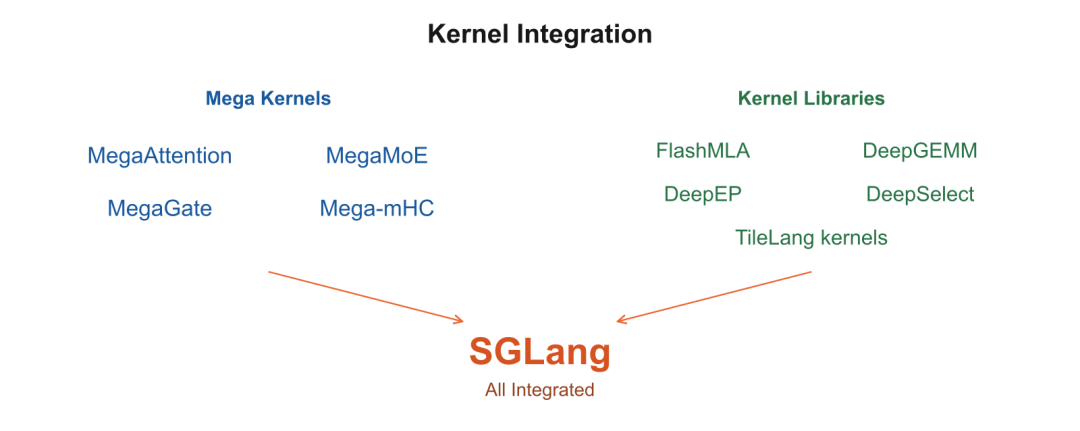
A primeira razão é direta: a DeepSeek abriu as peças. O DeepInfer distribui kernels como FlashMLA, DeepGEMM, DeepEP, DeepSelect e TileLang, além dos blocos MegaAttention, MegaMoE, MegaGate e Mega-mHC. O vLLM incorporou esses componentes e construiu em cima deles sua própria pilha de serving. A SGLang fez o mesmo em pontos como decode CUDA Graph, atenção e comunicação de especialistas.
A segunda razão é a linhagem. O próprio README do DeepInfer informa que ele foi construído principalmente sobre o vLLM, com inspiração adicional na SGLang e no TensorRT-LLM. Isso torna menos surpreendente que as curvas dos motores convirjam: eles compartilham kernels, ideias de escalonamento e aprendizados de serving. A competição não é entre uma equipe que começou do zero e outra que tinha anos de vantagem; é entre projetos que trocam otimizações e se retroalimentam.
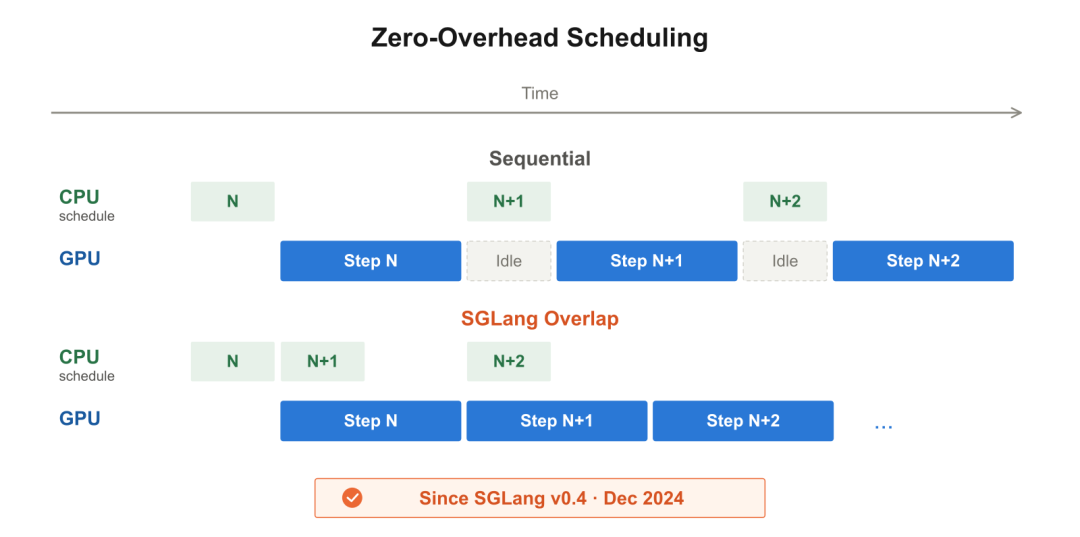
A terceira razão é engenharia de sistema, não apenas kernel. No estudo do vLLM, o ganho no rack vem de uma combinação de prefill/decode separados, Wide-EP, EPLB, transferência de KV por NIXL/UCX, escalonamento assíncrono e correções de overhead de CPU. Em um cluster grande, um kernel mais rápido pode ser desperdiçado se um rank atrasa a sincronização, se a admissão de requisições cria picos ou se o cache não é reaproveitado. É essa camada que transforma um bom modelo em um serviço previsível.
DeepInfer é um motor, não uma plataforma completa
O README do DeepInfer é explícito: a versão aberta oferece inferência offline e os recursos centrais para serving em escala, mas uma “inferência completa” ainda precisa de componentes que não estão incluídos nesta versão:
- sistema de cache KV;
- separação entre prefill e decode;
- balanceamento de carga entre réplicas de data parallel;
- operação de múltiplos modelos e hardwares em uma mesma frota.
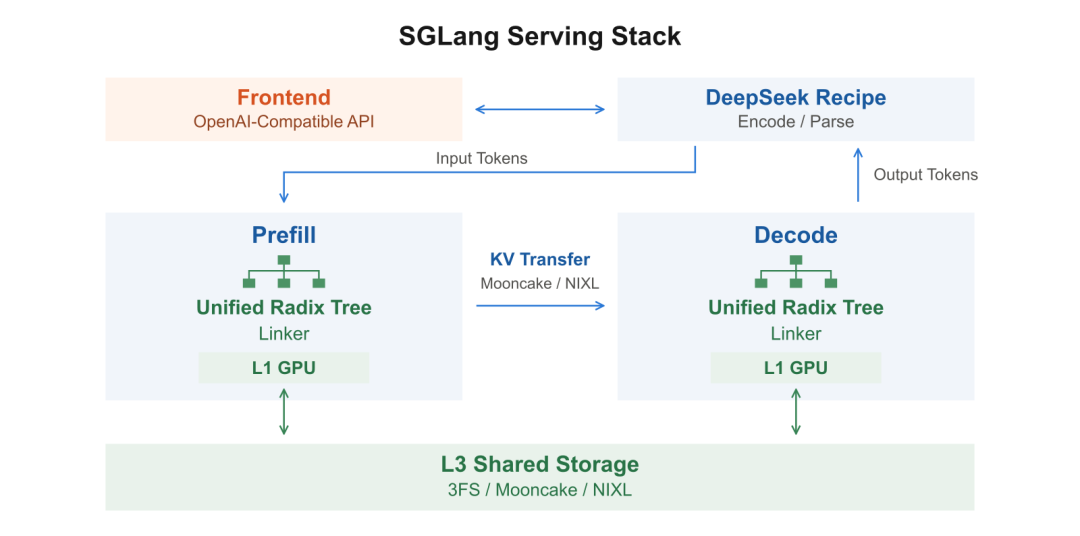
Isso não diminui o trabalho da DeepSeek. Pelo contrário: mostra que o motor resolveu uma parte difícil e mensurável. Mas significa que comparar o DeepInfer com o vLLM em uma curva de decode não responde a todas as perguntas de produção. Se você precisa de uma API online, de vários modelos no mesmo gateway, de roteamento por prefixo, de failover e de observabilidade, o vLLM ou a SGLang entregam mais peças prontas. Se você quer estudar o limite de um único modelo em modo offline, o DeepInfer é uma referência valiosa.
Auto-hospedar ou usar API?
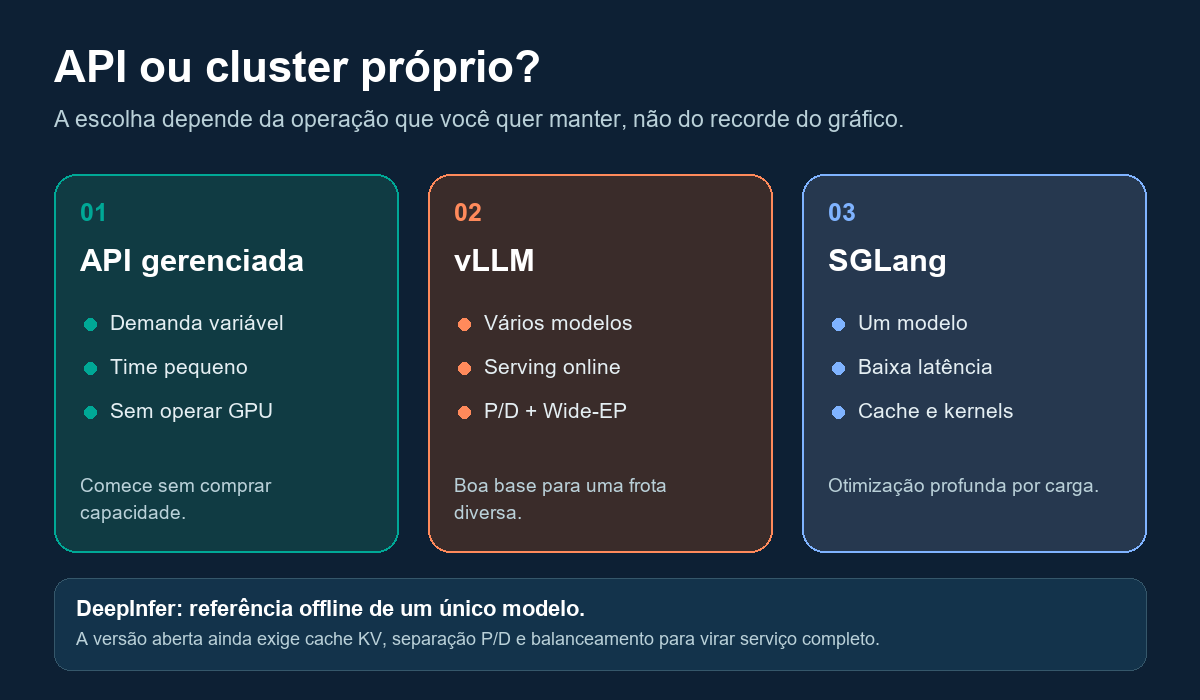
| Seu cenário | Caminho mais direto |
|---|---|
| Teste de produto, tráfego variável, time pequeno, sem equipe de GPU | API gerenciada |
| Cluster próprio, vários modelos, necessidade de serving online e controle do roteamento | vLLM |
| Um modelo específico, forte foco em baixa latência e equipe para ajustar kernels e cache | SGLang |
| Estudo offline do V4.1 Flash, comparação de kernels ou pesquisa de serving | DeepInfer, com a camada de produção construída separadamente |
O custo de auto-hospedagem não termina no aluguel da GPU. Você precisa somar capacidade ociosa, rede de alta velocidade, armazenamento, engenharia de plantão, atualizações de kernel, testes de regressão, monitoramento, recuperação de falhas e segurança. Para um time de produto que ainda está validando demanda, essa soma costuma dominar a conta. Para uma empresa com utilização alta e previsível, o cálculo pode inverter.
Na MandAPI, o DeepSeek V4.1 Flash · 1017 aparece no catálogo público com o ID deepseek-v4.1-flash-1017. Em 25 de outubro de 2026, a tabela de preços em reais mostrava R$ 0,39 por milhão de tokens de entrada e R$ 0,99 por milhão de tokens de saída. A mesma página comparava esses valores à tarifa oficial fora do pico, de R$ 0,76 e R$ 3,03, respectivamente. Os preços podem mudar; confirme o valor vigente antes de fazer uma estimativa.
Um exemplo hipotético: 1 milhão de tokens de entrada mais 100 mil de saída custariam R$ 0,489 em tarifa de modelo (R$ 0,39 + R$ 0,099), antes de cache, ferramentas, impostos ou outras condições da conta. É uma conta simples de vitrine, não uma promessa de fatura final. O ponto prático é que você consegue testar o modelo sem provisionar um rack GB300.
Como chamar o DeepSeek V4.1 Flash pela MandAPI
Crie uma chave na área de API Keys, guarde-a fora do código e use a rota compatível com OpenAI. O exemplo abaixo usa o ID publicado no catálogo:
curl https://api.mandapi.com/v1/chat/completions \
  -H "Authorization: Bearer ${MANDAPI_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-v4.1-flash-1017",
    "messages": [
      {"role": "user", "content": "Explique em português a diferença entre prefill e decode em uma API de LLM."}
    ]
  }'
Antes de integrar, confirme o ID e o estado do modelo no catálogo de modelos e consulte o guia da API compatível com OpenAI. A MandAPI cobra pelo uso, em reais, e permite trocar o campo model para comparar outros fornecedores com a mesma chave. Isso não significa que todo recurso nativo de cada fornecedor esteja disponível; valide streaming, tool calling e limites no seu caso de uso.
O que medir antes de escolher um motor
Um benchmark de vazão agregada não responde às perguntas de uma aplicação real. Para comparar vLLM, SGLang, DeepInfer ou uma API, registre:
- tempo até o primeiro token (TTFT) e tempo por token de saída (TPOT);
- tokens por segundo por usuário, não apenas tokens por segundo por GPU;
- taxa de acerto de cache e efeito de prompts repetidos;
- custo por tarefa concluída, incluindo tentativas que falharam;
- qualidade do resultado e número de revisões humanas;
- erros, timeouts, retentativas e comportamento sob pico;
- requisitos de residência de dados, auditoria e contratação.
Para agentes, uma tarefa pode fazer dezenas de chamadas e usar ferramentas. Nesse caso, a latência de uma chamada isolada diz pouco. Meça o tempo de ponta a ponta e a taxa de conclusão. Para chatbots, o TTFT e a suavidade do streaming importam mais do que a vazão máxima em lote 256. Para processamento em lote, o custo por milhão de tokens e a utilização do cluster podem pesar mais.
Perguntas frequentes
O vLLM superou o DeepInfer?
Não há uma resposta universal. No teste de decode do vLLM em GB200, com contexto de 131K, nextn=3 e lotes de 8 a 256, a vazão ficou dentro de 6% da publicada pelo DeepInfer. Isso mostra proximidade naquele recorte, não superioridade em todos os modelos, hardwares ou cargas. Além disso, o DeepInfer aberto é uma versão offline e não inclui toda a camada de serving.
O DeepInfer é suficiente para colocar uma API em produção?
A versão aberta não inclui, segundo o próprio projeto, um sistema completo de cache KV, separação prefill/decode e balanceamento entre réplicas. Para uma API multiusuário, você precisa construir ou integrar essa camada. O DeepInfer é mais útil como motor de referência e para experimentos offline do V4.1 Flash.
Qual é a diferença entre vLLM e SGLang para o DeepSeek V4.1 Flash?
Ambos são motores genéricos que receberam otimizações específicas para o modelo. O vLLM publicou um estudo forte de escala com P/D e Wide-EP em GB300 NVL72. A SGLang publicou um estudo de kernels que levou o decode em lote 1 a 873,6 tokens/s em quatro GB300. A escolha depende do seu hardware, do tipo de tráfego e da maturidade do seu time para operar cada pilha.
Preciso de GPU para usar o DeepSeek V4.1 Flash?
Não, se usar uma API. Pela MandAPI, você cria uma conta, gera uma chave e chama deepseek-v4.1-flash-1017 pela rota de Chat Completions. Para auto-hospedar, espere uma operação com múltiplas GPUs de data center, não uma única GPU de consumidor: o modelo tem 552 bilhões de parâmetros e os benchmarks oficiais usam SM100, B300, GB300 ou hardware equivalente.
Quanto custa o DeepSeek V4.1 Flash na MandAPI?
Em 25/10/2026, a tabela pública mostrava R$ 0,39 por milhão de tokens de entrada e R$ 0,99 por milhão de tokens de saída para o ID deepseek-v4.1-flash-1017. Consulte a página de preços para o valor atual e para as condições de cache e cobrança.
Os números do vLLM, da SGLang e do DeepInfer podem ser comparados diretamente?
Não sem alinhar hardware, lote, tamanho de contexto, proporção entre entrada e saída, uso de speculative decoding, cache e método de medição. O 954 mil tokens/s por GPU é uma vazão agregada em um rack; o 873,6 é um resultado de baixa concorrência em quatro GPUs; a diferença de 6% é uma comparação de decode no GB200. São três perguntas diferentes.
Fontes e leitura relacionada
Fontes primárias: estudo do vLLM sobre DeepSeek V4.1 Flash, 23/10/2026; otimização de kernels da SGLang para DeepSeek V4.1 Flash; suporte Day-0 da SGLang e Miles; repositório e README do DeepInfer; model card do DeepSeek V4.1 Flash.
Leia também o preço, benchmarks e API do DeepSeek V4.1 Flash 1017, o guia da API compatível com OpenAI e o catálogo de modelos. Para estimar o custo no seu fluxo, use a calculadora de preços.